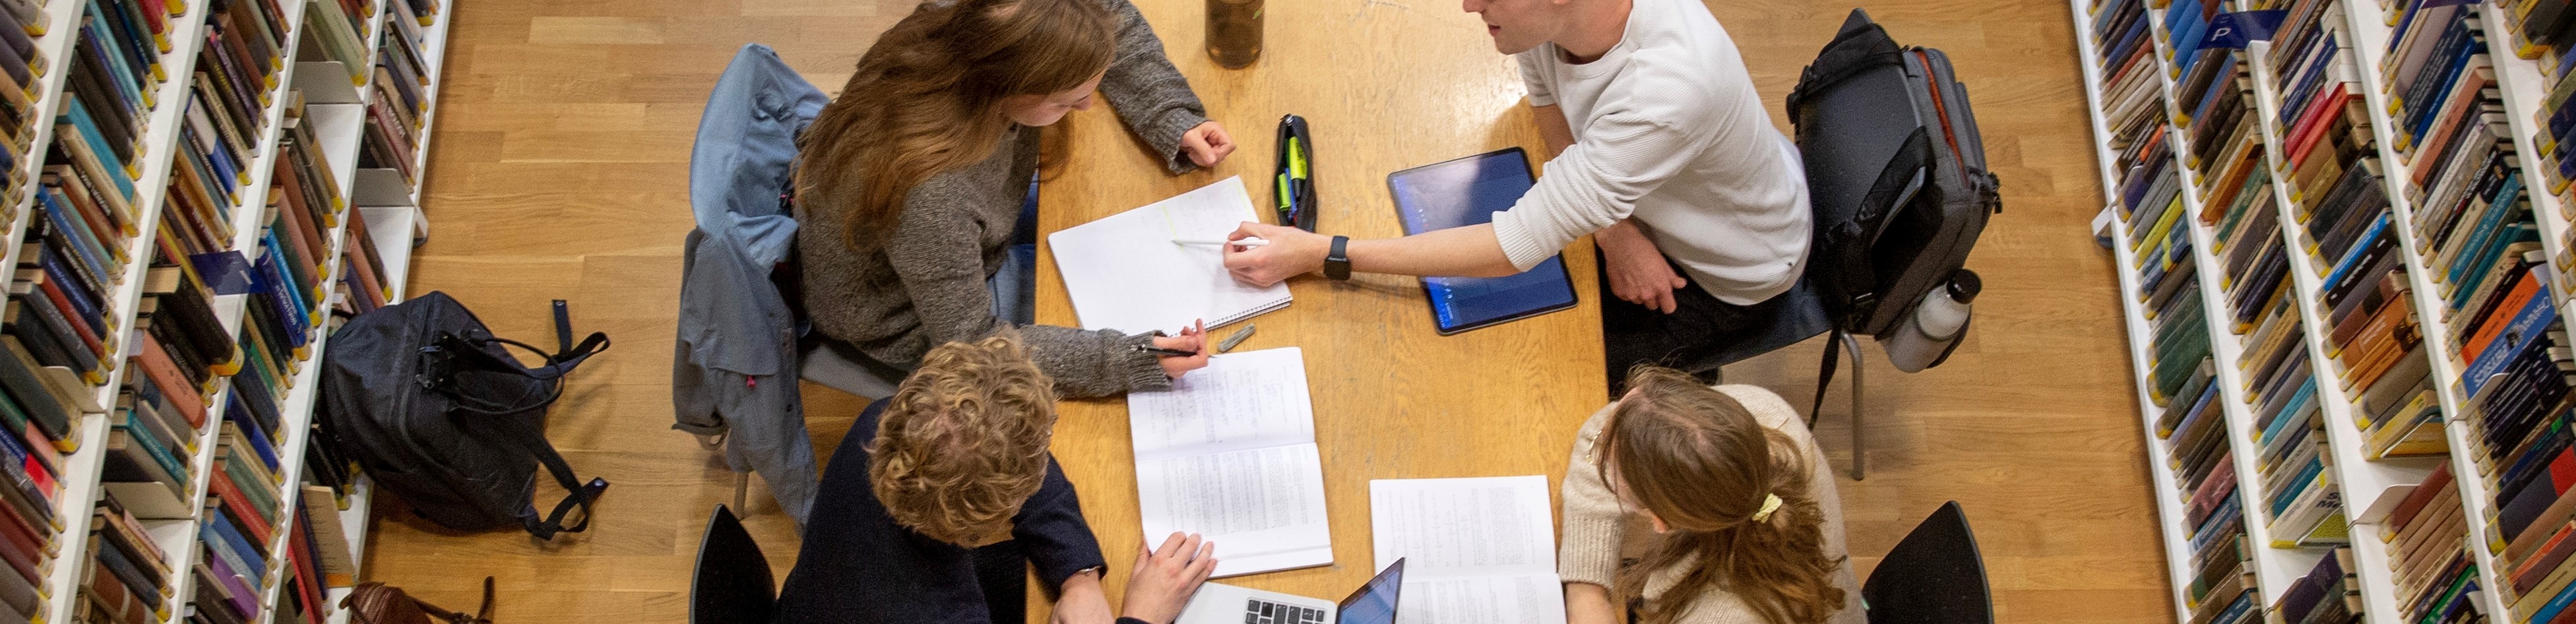
Studerende udarbejder løsninger til at forudsige kategorisering af to store datasæt gennem machine learning. Løsningerne indgår i en konkurrence på holdet om, hvem der kan udarbejde den mest præcise løsning. Dette mimer reelle forskningsstrategier indenfor maskinlæring med analyse af data
Vi ønskede at få vores opgave til at ligne en rigtig maskinlæringskonkurrence. Fordelen er, at det får de studerende til at tænke over, hvordan man vurderer præstationen på en upartisk måde og prøver reelle forskningsstrategier af indenfor feltet.
De studerende vil efter kurset have den nødvendige teoretiske og praktiske baggrund til at arbejde med modellering og forståelse af forskellige typer af genomiske datasæt med fokus på forudsigelse og klassifikation. De studerende vil udvikle en detaljeret viden om aktuelle metoder inden for statistisk læring, der er specielt tilpasset (store) genomiske datasæt.
CASENS FORLØB | |||
Gruppearbejde |
| ||
Delaflevering med underviserfeedback |
| ||
Tilpasning af deres model |
| ||
Afgørelse af konkurrence |
| ||
RESSOURCER TIL STUDERENDE |
Litteratur:
|
Vores erfaring er at muligheden for at arbejde i grupper og samtidig have en element af konkurrence i øvelserne er stærkt motiverende for mange.
Samtidig tvinger designet de studerende til at bruge centrale elementer fra machine learning. At få unbiased estimater af test error ved hjælp af f.eks. cross validation og få styr på hvordan man sammenligner modeller - både teoretisk og praktisk.
Til sidst i kurset lærer de også om at kombinere modeller – og de sidste afleveringer er meget ofte kombinationer af modeller med forskellige bias og varians.
“Gamification” virker stærkt motiverende på rigtig mange. Samtidig virker det meget motiverende for studerende på et machine learning kursus at de har prøvet noget der er identisk med rigtige ML konkurrence (kaggle.com).
Fordelen er også at vi laver assignments som vi som undervisere selv synes er sjove/motiverende at lave.
Det er ikke alle der synes konkurrence er sjovt. Der er også studerende der klarer sig ret dårligt i konkurrencen og aldrig rigtig får investeret i det.
Det er ofte udfordrende at finde data som er tæt på forskningen og som samtidig er gode/nemme nok til at bruge til undervisning. Der er tit udfordringer med “rigtige” data som gør det frustrerende for studerende at arbejde med dem.
| Undervisers navn | Palle Villesen, Thomas Bataillon, Asger Hobolth |
| Fakultet og institut | NAT, Center for bioinformatik |
| Uddannelse | Bioinformatik |
| Kursus | Statistical and Machine Learning in Bioinformatics |
| Studieniveau | Kandidat |
| Undervisningsform | Forlæsning, holdundervisning |
| Omfang | Kursus |
| Organisering | Tilstedeværelses undervisning |
Gareth James et al. 2022: "An Introduction to Statistical Learning in R with Applications in R". 2nd edition.
Udvalgte forskningsartikler og bogkapitler.